
Mybatis
阅读提示
建议先看题目目录,再按“概念 -> 原理 -> 场景 -> 优化”顺序复习。
每题先讲结论,再补关键机制和项目实践,回答会更稳。
本文适用于 MyBatis 3.5.x(默认配置按该系列说明),不包含 MyBatis-Plus 的扩展行为。涉及旧版本差异时单独注明。
1、什么是Mybatis(了解)
- Mybatis 是一个半ORM框架,它内部封装了 JDBC,开发时只需要关注 SQL 语句本身,不需要花费精力去处理加载驱动、创建连接、创建statement 等繁杂的过程。程序员直接编写原生态 sql,可以严格控制 sql 执行性能,灵活度高。MyBatis 可以使用 XML 或注解来配置和映射原生信息,将 POJO 映射成数据库中的记录,避免了几乎所有的 JDBC 代码和手动设置参数以及获取结果集。通过 xml 文件或注解的方式将要执行的各种 statement 配置起来,并通过java 对象和 statement 中 sql 的动态参数进行映射生成最终执行的 sql 语句,最后由 mybatis 框架执行 sql 并将结果映射为 java 对象并返回。
2、#{}和${}的区别是什么?
预编译与字符串替换:
#{}:表示一个预编译的SQL参数占位符。当使用#{}时,在默认的statementType="PREPARED"下,MyBatis 会把#{}转为 SQL 中的?,再通过 TypeHandler 调用 JDBC PreparedStatement 的参数设置方法绑定值。这种方式可以防止SQL注入,因为它确保用户输入被当作参数值而不是SQL的一部分来处理。${}:表示一个字符串替换占位符。当使用${}时,MyBatis会直接将参数值替换到SQL语句中,而不是作为参数值来处理。这意味着用户输入的内容将被直接插入到SQL语句中,因此存在SQL注入的风险。数据类型处理:
#{}:MyBatis会处理参数的数据类型,并确保参数值被正确地传递给JDBC的PreparedStatement对象。参数为 null 时需要合适的 JDBC 类型,例如#{name,jdbcType=VARCHAR};未指定时使用jdbcTypeForNull(默认 OTHER),并非所有驱动都接受这一默认值。${}:MyBatis不会处理参数的数据类型。你需要确保替换的字符串是有效的SQL片段,并且如果参数是null,则需要在SQL语句中显式处理它。
例如下面的参数绑定过程,值始终与 SQL 结构分开:
where name = #{name}  →  where name = ?
name = "O'Reilly"     →  PreparedStatement 绑定字符串值
#{} 只能绑定值,不能用来替换表名、列名或 ASC/DESC。动态排序优先用 <choose> 输出固定片段;必须使用 ${} 时,应把外部选项映射到服务端白名单中的固定标识符,不能直接拼入用户输入。参数绑定也不能保护 SQL 中其他直接拼接的部分。参见 官方参数与字符串替换说明。
3、当实体类中的属性名和表中的字段名不一样 ,怎么办 ?
- 第1种: 通过在查询的sql语句中定义字段名的别名,让字段名的别名和实体类的属性名一致。
<select id="selectOrder" parameterType="int" resultType="me.gacl.domain.Order">
  select order_id as id, order_no as orderno, order_price as price
  from orders where order_id = #{id}
</select>- 第2种:通过
resultMap显式映射列名与属性名(示例实体Order含id、orderno、price属性,实际使用时替换为项目类名)。以下片段放在 Mapper 的<mapper>内;resultMap应在查询语句之前定义。
<resultMap type="me.gacl.domain.Order" id="orderResultMap">
  <id property="id" column="order_id"/>
  <result property="orderno" column="order_no"/>
  <result property="price" column="order_price"/>
</resultMap>

<select id="getOrder" parameterType="int" resultMap="orderResultMap">
  select order_id, order_no, order_price from orders where order_id = #{id}
</select>
若只是 order_id 与 orderId 这样的下划线/驼峰差异,也可启用 mapUnderscoreToCamelCase=true(默认 false);它不能把 order_id 自动变为 id。参见 官方结果映射说明。
4、Mybatis是否支持延迟加载?如果支持,它的实现原理是什么?
- 支持
association、collection的嵌套查询延迟加载,即关联上配置select引用另一个查询。通过 JOIN 得到同一结果集再做嵌套结果映射,并不是延迟执行关联 SQL。 lazyLoadingEnabled默认 false,关联上的fetchType="lazy"或fetchType="eager"可覆盖全局设置。MyBatis 3.5.x 默认代理工厂为 Javassist(自 3.3 起);CGLIB 从 3.5.10 起已弃用。- 机制是为结果对象生成代理,并记录尚未加载属性及对应的查询信息。访问这些属性时,拦截器检查待加载记录,执行关联查询、写回属性并移除记录,而不是简单判断属性是否为 null;查询结果本来就可能为 null。
aggressiveLazyLoading在 3.5.x 默认 false,通常按属性加载;设为 true 时任意方法调用都可能加载全部延迟属性。此外默认lazyLoadTriggerMethods包含equals、clone、hashCode、toString,所以打印日志也可能触发查询。- 查询 N 条主记录后逐一访问关联,仍可能产生 N+1 次查询。是否使用延迟加载,应结合实际访问方式选择 JOIN 或批量查询;不能将其等同于减少查询次数。
5、说说Mybatis的缓存机制:
- Mybatis整体:
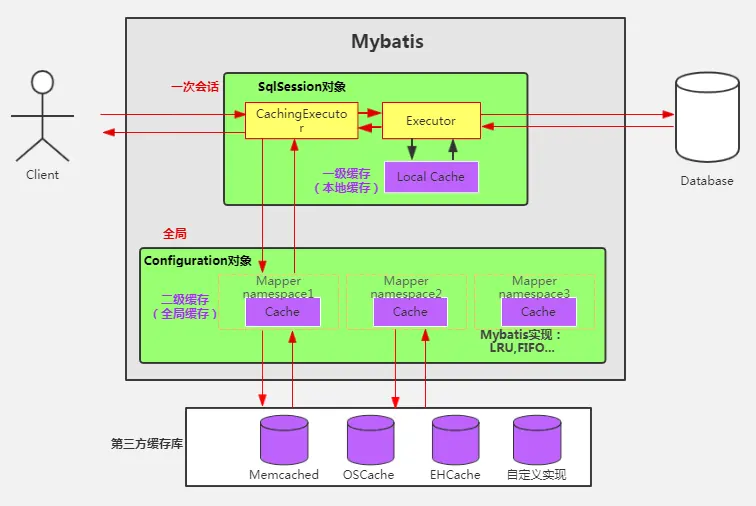
- 一级缓存localCache
- 在应用运行过程中,我们有可能在一次数据库会话中,执行多次查询条件完全相同的 SQL,MyBatis 提供了一级缓存的方案优化这部分场景,在缓存键相同且未被清理时,会优先命中一级缓存,避免直接对数据库进行查询,提高性能。
- 每个 SqlSession 中持有了 Executor,每个 Executor 中有一个 LocalCache。当用户发起查询时,MyBatis 根据已解析的 MappedStatement 构造缓存键,在 Local Cache 中查询,如果缓存命中的话,直接返回结果给用户,如果缓存没有命中的话,查询数据库,结果写入 Local Cache,最后返回结果给用户。具体实现类的类关系图如下图所示
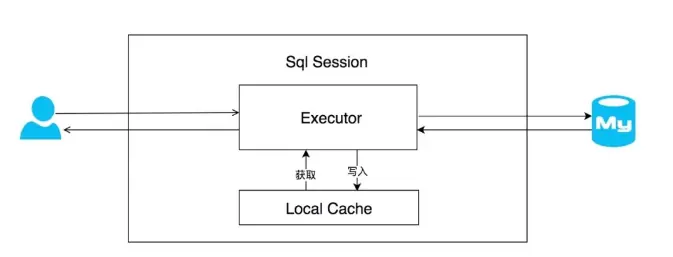
一级缓存默认作用域为
SESSION,随 SqlSession 关闭而清理;执行更新、提交、回滚或调用clearCache()也会清理。缓存键不仅含 SQL,还包括 statement ID、分页范围(RowBounds)、绑定参数值及环境 ID,因此 SQL 文本相同不代表一定命中。MyBatis 一级缓存内部设计简单,只是一个没有容量限定的 HashMap,在缓存的功能性上有所欠缺。
其他 SqlSession 或外部程序更新数据库,不会主动清理当前会话的一级缓存,可能继续返回旧值。需要避免跨调用复用查询结果时可设置
localCacheScope=STATEMENT;它仍保留单次语句执行期间的缓存以处理嵌套查询和循环引用,也不改变数据库事务隔离级别。二级缓存
在上文中提到的一级缓存中,其最大的共享范围就是一个 SqlSession 内部,如果多个 SqlSession之间需要共享缓存,则需要使用到二级缓存。开启二级缓存后,会使用 CachingExecutor 装饰Executor,进入一级缓存的查询流程前,先在 CachingExecutor 进行二级缓存的查询,具体的工作流程如下所示。
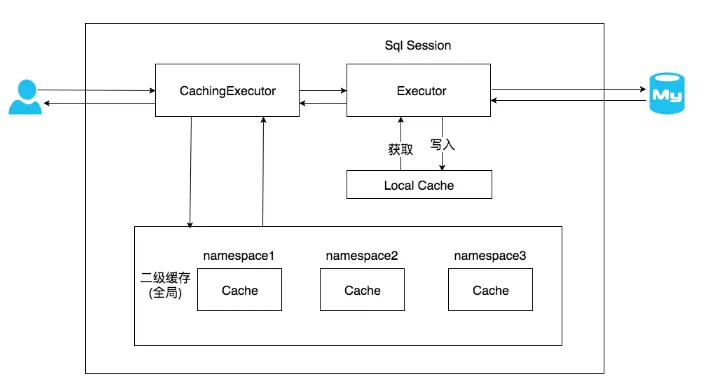
二级缓存开启后,同一个 namespace 下的所有操作语句,都影响着同一个 Cache,即二级缓存被多个 SqlSession 共享,范围通常是同一 SqlSessionFactory 中的该 namespace,而非跨 JVM 的全局变量;可通过
<cache-ref>让多个 namespace 共用缓存。cacheEnabled默认 true 只是允许使用二级缓存,还需 Mapper 配置<cache/>、<cache-ref>或相应注解。默认 select 的useCache=true、flushCache=false;增删改默认flushCache=true。useCache=false不会关闭一级缓存。二级缓存采用事务性暂存:查询后通常在提交时发布到共享缓存,回滚会丢弃待提交项;不能认为另一会话在查询完成瞬间就一定可见。
对于可使用二级缓存的普通查询,流程为:
二级缓存 -> 一级缓存 -> 数据库
MyBatis 的二级缓存相对于一级缓存来说,实现了 SqlSession 之间缓存数据的共享,同时粒度更加细,能够到 namespace 级别,通过 Cache 接口实现类不同的组合,对 Cache 的可控性也更强。
二级缓存按 namespace 管理,不跟踪 SQL 的表依赖。若 A Mapper 的 JOIN 查询涉及 B 表,而 B Mapper 更新该表却未共享同一个缓存,A 的旧结果可能残留;并非所有多表查询都会出错,关键在于失效范围是否覆盖所有写入路径。
默认二级缓存位于本进程内,多实例部署时不同实例的缓存不会自动失效。集中式 Cache 实现只能解决共享存储的一部分问题,仍需设计写入失效、事务时序及外部写入的处理;直接接入 Redis 并不自动保证一致性。