
HashMap 底层原理:JDK 21 扩容、树化条件与线程安全
HashMap 的底层是哈希桶数组,冲突元素用链表或红黑树组织;哈希分布良好时,put/get 通常接近 O(1)。它允许一个 null 键和多个 null 值,不保证遍历顺序,也不提供并发写入安全。面试中的 8/64/6 是不同实现路径上的阈值,不能合并成“到 8 必树化、到 6 必退化”。
适用版本: 本文以 Java SE 21 HashMap API 和 OpenJDK jdk-21-ga 源码 为核对基准。JDK 8 引入链表与红黑树结合的实现;文中的 JDK 1.7/1.8 对比用于解释历史变化。树化细节属于实现策略,不是 Map 接口对所有 JDK 的承诺。
1、HashMap 的底层数据结构是什么?
回答提示:
- JDK 1.7:数组 + 链表。
- JDK 8 起(本文核对 JDK 21):数组 + 链表 + 红黑树。
- 当桶内链表过长且容量达到条件时,链表会树化,提高查询效率。
参考回答:
- HashMap 的底层是哈希桶数组,桶里存放
Node<K, V>。 - 发生哈希冲突时,桶中通过链表或树组织节点;链表插入触发树化检查后,还要满足表容量条件,具体边界见第 6 题。
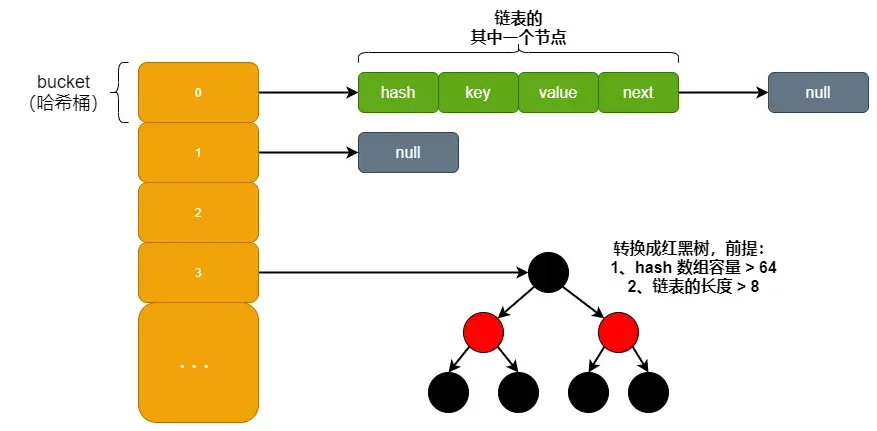
图示表达桶与节点的关系。图中文字“数组容量 >64”为旧示意;JDK 21 在数组长度小于 64 时优先扩容,至少 64 才进入树化分支。链表触发检查的计数与具体方法有关,以第 6 题的源码说明为准。
2、HashMap 的默认初始化参数有哪些?
回答提示:
- 默认初始容量:
16。 - 默认负载因子:
0.75。 - 扩容阈值:
capacity * loadFactor。
参考回答:
- 默认情况下,HashMap 在第一次
put时初始化数组容量为 16。 - 普通
put新增映射后,若元素个数超过阈值(容量 * 负载因子),触发扩容,容量通常翻倍。
这里的默认情况指无参构造;创建空对象时不会立刻分配长度为 16 的数组。size 是整个 Map 的键值对数量,容量是桶数组长度;覆盖已有 key 不增加 size。例如默认表容量为 16、阈值为 12,在没有冲突引发提前扩容的情况下,插入第 13 个不同 key 才因超过负载阈值扩容。
3、HashMap 的 put 流程是怎样的?
回答提示:
- 计算 key 的 hash。
- 定位桶下标(位运算)。
- 桶为空直接插入。
- 桶不为空则比较 key:相同覆盖,不同挂链表/树。
- 判断是否需要树化或扩容。
参考回答:
put核心逻辑就是“算桶位 + 冲突处理 + 阈值判断”。- 冲突时先比较
hash和equals,相同 key 走覆盖;不同 key 追加到链表尾或红黑树。
JDK 21 对非空 key 的哈希做高位扰动,再用 (n - 1) & hash 定位桶,n 为数组长度。定位到同一桶不代表 key 相等;自定义 key 应保持 equals/hashCode 一致,放入后不要修改参与这两个方法计算的字段,否则可能无法按原 key 查到数据。
4、HashMap 的 get 流程是怎样的?
回答提示:
- 计算 key 的 hash 并定位桶。
- 先比较头节点。
- 若是链表则遍历匹配。
- 若是红黑树则按树查找。
参考回答:
get的时间复杂度在理想情况下接近 O(1),冲突严重时会退化。- JDK 8 起通过树化降低极端冲突下链表查询的退化风险,树桶的复杂度边界见第 7 题。
get(key) 返回 null 既可能表示 key 不存在,也可能表示对应的 value 为 null;需要区分时用 containsKey(key)。
5、哈希冲突怎么处理?
回答提示:
- HashMap 主要采用拉链法(链地址法)。
- 同一个桶位的不同 key 通过链表或红黑树组织。
参考回答:
- 哈希冲突不可避免,关键是“冲突后怎么组织”。
- HashMap 采用“数组 + 链/树”结构,把冲突元素放在同一个桶中并继续检索。
6、链表什么时候转红黑树?红黑树什么时候退化回链表?
回答提示:
8:树化检查阈值,但要结合插入入口的计数方式理解。64:允许树化的最小桶数组长度,不是 Map 元素个数。6:扩容时树桶拆分后,每一侧转回链表的节点数阈值;普通删除使用另一套判断。
参考回答:
在 OpenJDK 21 中,需要分清以下路径:
| 路径 | 实际条件与边界 |
|---|---|
普通 put / putVal 插入链表 | 桶内已有 8 个节点,追加第 9 个不同 key 时,循环计数才满足 binCount >= TREEIFY_THRESHOLD - 1,调用 treeifyBin。覆盖已有 key 不触发这次追加检查。 |
treeifyBin 决定树化还是扩容 | 当前数组长度达到 64 才树化;小于 64 则调用扩容,本次调用不会在扩容后接着树化。扩容可能把冲突元素分到不同桶。 |
扩容时的 TreeNode.split | 按哈希位拆为低位、高位两组;分别计数,某组节点数不超过 6 就把该组转为链表,超过 6 的非空组保留树结构。 |
普通删除的 removeTreeNode | 依据树的形状及 movable 标志判断是否过小,并非每次删除都数到 6 再转换。迭代器删除传入 movable=false,也不能套用“剩 6 个必退化”。 |
computeIfAbsent、compute、merge 的链表遍历和插入计数与普通 put 不同,不应把“第 9 个”推广到所有入口。回答时先说常量,再说明具体方法与容量条件。可在 JDK 21 调试器中使用初始容量 64、固定返回同一 hash 且 equals 能区分的 key,逐次 put,观察第 8 次和第 9 次插入的分支;不要用反射检查内部结构作为业务逻辑。
7、为什么要引入红黑树?
回答提示:
- 解决极端冲突下链表查询退化到 O(n) 的问题。
- 在 hash 或可比较的 key 能有效区分查找方向时,树桶查找可按 O(log n) 理解,
n指桶内节点数。
参考回答:
- 红黑树是为了优化最坏情况性能,不是为了替代链表。
- 在冲突不严重时,链表简单且维护成本低;冲突严重时,树结构更稳。
不要把树高 O(log n) 等同于任何 key 下查找都保证 O(log n):若大量 key 的 hash 相同,又无法通过可比较关系确定方向,源码查找可能搜索两侧子树,仍有线性退化的风险。合理设计 hashCode 依然重要。
8、HashMap 在什么情况下扩容?
回答提示:
- 普通
put在新增映射后检查++size > threshold,超过负载阈值时扩容。 - 树化检查发现数组长度不足 64 时,也可能提前扩容。
- 扩容通常翻倍;达到最大容量后不会无限翻倍。
参考回答:
- 扩容会带来一次性开销,因此在已知数据量场景建议设置合理初始容量,减少频繁扩容。
JDK 21 扩容会重新分布节点,但通常不重新调用 key 的 hashCode():利用节点保存的 hash 与旧容量做位判断,链表节点留在原下标或移到“原下标 + 旧容量”,并保持各组内的相对顺序。预估容量时也要区分桶数与元素数;JDK 19 起可用 HashMap.newHashMap(expectedMappings) 按预计键值对数创建,避免直接把预计数量当作构造器容量。
扩容为什么只需分成两组?OpenJDK 21 的桶数组长度为 2 的幂,翻倍时下标掩码只多出一位。例如从 16 扩为 32:
旧掩码 15:0b01111     新掩码 31:0b11111
保存的 hash =  5:旧下标 5 → 新下标  5(hash & 16 == 0)
保存的 hash = 21:旧下标 5 → 新下标 21(hash & 16 != 0)
因此只需检查 hash & oldCapacity,无需重新计算 key 的哈希。这里的 hash 是节点中保存的扰动结果;非空 key 的计算式为 h ^ (h >>> 16),其中 h = key.hashCode(),空 key 的 hash 为 0。高位扰动让高位信息也参与低位桶索引,但不能消除冲突。拆分保留组内顺序,不代表整个 Map 的遍历顺序稳定。以上对应 OpenJDK 21 的 hash 与 resize。
扩容检查时机也有入口差别:JDK 21 的 computeIfAbsent、compute、merge 在方法前部检查已有的 size > threshold,新增节点后只增加 size,没有普通 put 那样的末尾负载检查。因此这些入口可能在本次插入后暂时超过负载阈值,到后续调用才检查扩容;不能把“第 13 次插入立刻扩容”推广到所有方法。树化引发的提前扩容仍是另一条路径。
9、JDK 1.7 与 1.8 在扩容迁移上的差异
回答提示:
- 1.7 迁移时头插法,链表顺序可能反转。
- 1.8 起迁移按高低位拆分并保留组内顺序;这不构成并发访问保证。
参考回答:
- 常见面试追问是 1.7 扩容并发下的链表成环问题。
- 1.8 在结构和迁移策略上做了改进,但 HashMap 依然不是线程安全容器。
10、HashMap 为什么线程不安全?
回答提示:
- 多线程下可能出现覆盖、丢失、结构异常。
- 并发扩容和写入存在竞态条件。
参考回答:
- HashMap 适用于单线程或外部同步场景。
- 并发读写建议使用
ConcurrentHashMap。
只读共享也需要安全发布,且发布后不再修改;迭代器的 fail-fast 只是尽力发现错误,不能依赖 ConcurrentModificationException 保证线程安全。换成 ConcurrentHashMap 后,“先检查再写入”等复合操作仍应使用 putIfAbsent、compute 等合适的原子 API。
11、面试如何表达得更工程化?
可直接复述模板:
- 我一般先确认访问模式(读多写少还是高并发写入),再决定用 HashMap 还是 ConcurrentHashMap。
- 如果数据量可预估,我会提前设置初始容量,减少扩容抖动。
- 如果 key 分布不均,我会重点关注冲突桶和热点 key,避免局部性能退化。
参考资料
- Java SE 21:HashMap API:容量、负载因子、空值、同步要求与
newHashMap的公开契约。 - OpenJDK 21 GA:HashMap.java:对照
putVal、treeifyBin、resize、TreeNode.find、split与removeTreeNode阅读实现边界。
本次修订(2026-11-06):以 JDK 21 核对树化 8/64、扩容拆分退化 6 与普通删除的区别,补充扩容、查询复杂度和并发使用边界。
复习后可到学习资源入口选择配套材料,围绕“为什么第 8 次普通 put 没树化”整理一份自己的源码追问笔记。
继续阅读与资料
复盘参考:把 HashMap 回答整理成可检查的任务。