
集合框架
阅读提示
集合题核心是三条线:整体分类、常用容器对比、HashMap 原理。
回答时尽量带复杂度和适用场景,避免只背定义。
本文以 Java SE 17 API、OpenJDK 17u 实现为核对基准;JDK 7/8 仅用于历史对比。扩容倍率、树化阈值属于实现细节,不是所有 Java 实现必须遵守的 API 契约。
Java集合
回答提示:是一种比较通俗的解释,比较好理解,如果‘参考答案’不太好记住,可以直接复习回答提示也可以。
1、Java中的集合类有哪些?如何分类的?(此问题基本不会被问到,但是要大体理解整个集合的内容,如果能记住此问题(灵活记住),面试集合的基础问题基本都可以回答)
回答提示:
- List(列表):List接口及其实现类用于存储一组有序的元素。元素可以重复,且可以通过索引访问。常见的List实现类有ArrayList、LinkedList等。ArrayList基于动态数组实现,访问元素速度快;LinkedList基于双向链表实现,首尾插删为 O(1),包含按索引定位的插删通常为 O(n)。
- Set(集合):Set接口及其实现类用于存储一组不重复的元素;是否有迭代顺序由实现决定(如 LinkedHashSet 保留插入顺序、TreeSet 排序)。Set不允许出现重复元素,因此常用于去重操作。常见的Set实现类有HashSet、TreeSet等。HashSet基于哈希表实现,元素存储无序;TreeSet基于红黑树实现,元素会按照自然顺序或者自定义顺序排序。
- Queue(队列):Queue接口及其实现类通常按先进先出(FIFO)组织元素,但并非全部如此,例如 PriorityQueue 按优先级取出队首,迭代也不保证排序。常见的Queue实现类有LinkedList(也实现了List接口)、PriorityQueue等。LinkedList可以用作双端队列;PriorityQueue是一个基于优先级堆的无界队列,元素的排序方式可以通过比较器来定义。
- Map(映射):Map接口及其实现类用于存储键值对。键是唯一的,每个键都映射到一个值。常见的Map实现类有HashMap、TreeMap等。HashMap基于哈希表实现,键值对存储无序;TreeMap基于红黑树实现,键会按照自然顺序或者自定义顺序排序。
参考回答:
- 集合框架主要位于
java.util,并发集合主要位于java.util.concurrent。Collection下有 List、Set、Queue 等接口,Queue 不属于 List;Map 是独立的接口层次。 - Collection:Collection 是集合 List、Set、Queue 的最基本的接口。
- Iterator:迭代器,可以通过迭代器遍历集合中的数据
- Map:是映射表的基础接口
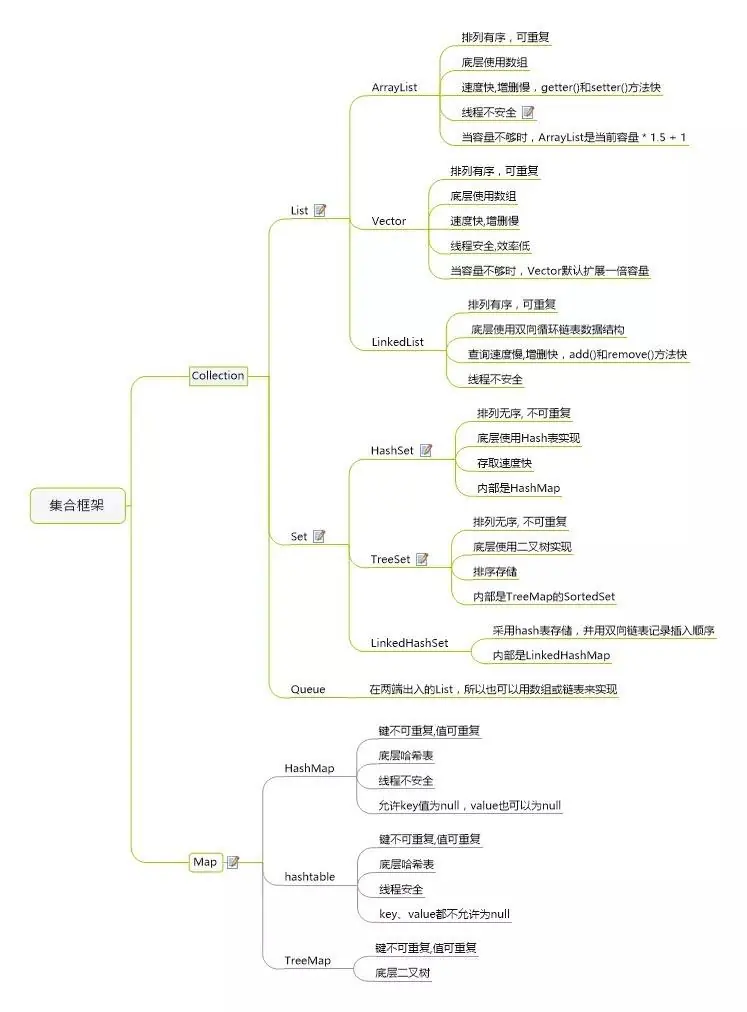
- 一定要牢牢记住这张图,大多比较浅的面试题都是从这上面问的。 ArrayList 在 OpenJDK 17u 中通常以约 1.5 倍作为优先增长量,但仍需满足最小所需容量和数组大小限制
2、那些集合是线程安全的?
参考回答:
- Vector:一个线程安全的List实现,它的大部分方法都是同步的,因此可以在多线程环境中使用。不过,由于同步操作会带来性能开销,所以在不需要线程安全的场合,建议使用ArrayList。
- Hashtable:一个线程安全的Map实现,它同样是同步的,可以在多线程环境中使用。与HashMap相比,Hashtable的性能可能稍差一些,因为同步操作会增加额外的开销。
- Stack:一个线程安全的栈实现,它也是同步的,可以在多线程环境中使用。官方建议优先使用 Deque 接口表达栈操作;单线程常用 ArrayDeque,它本身不保证线程安全。
- ConcurrentHashMap:一个线程安全的 Map 实现(不是 HashMap 的子类,且不接受 null 键和值)。早期版本(JDK 1.7 及以前)使用分段锁(Segment Locking)技术来提升并发性能,JDK 1.8 以后则使用了更加细粒度的锁,如空桶插入使用 CAS,非空桶更新通常在桶首节点上使用 synchronized,树桶另有协调机制。在多线程环境下,ConcurrentHashMap 的并发性能通常优于 Hashtable 以及通过
Collections.synchronizedMap(new HashMap<>())包装得到的同步 HashMap,因为后两者都是对整个 map 加锁,从而限制了并发能力,而 ConcurrentHashMap 则支持更高的并发访问。 - CopyOnWriteArrayList:一个线程安全的List实现,它通过在写操作时复制整个数组来实现线程安全。这种策略适用于读多写少的场景,因为写操作会涉及到复制整个数组,所以性能开销较大。
这些容器的线程安全不代表任意多步业务操作都是原子的。例如 ConcurrentHashMap 的“读取后加一再写回”应改用 merge(key, 1, Integer::sum) 等原子方法;同步包装集合的遍历还需要按官方要求在包装对象上加锁。CopyOnWriteArrayList 的迭代器读取创建时的数组快照,不反映后续写入,也不支持迭代器自身的增删改。
3、ArrayList的扩容机制是什么?
回答提示:
- 初始容量:OpenJDK 17u 的无参
new ArrayList<>()先使用共享空数组,首次添加元素时通常分配容量 10;new ArrayList<>(0)则首次添加时只需容量 1。容量与size()不同。 - 扩容触发:当向ArrayList中添加元素,且当前元素数量达到容量上限时,就会触发扩容操作。
- 扩容策略:ArrayList的扩容策略是增长大约50%的容量。
- 数组复制:扩容过程中,ArrayList会创建一个新的、更大容量的数组,并将原有数组中的所有元素复制到新数组中。
参考回答:
- OpenJDK 17u 通常优先增长
oldCapacity >> 1,即新容量约为旧容量的 1.5 倍;如果该增长不足以容纳批量添加所需元素,则至少满足最小所需容量,并处理数组长度上限。扩容通过复制元素引用到新数组实现,不会复制元素对象本身。尾部追加的均摊时间为 O(1),单次扩容为 O(n)。增长策略由类库实现决定,不由 JVM 规范规定。
4、ArrayList和linkedList的区别?
回答提示:
- 内部实现:ArrayList是基于动态数组实现的,元素引用存放在同一数组中(元素对象本身不保证连续);而LinkedList则是基于双向链表实现,元素通过指针相互连接。
- 随机访问:ArrayList支持快速随机访问,时间复杂度为O(1);LinkedList则需要遍历,时间复杂度为O(n)。
- 内存占用:LinkedList每个节点除了存储数据外,还需要存储指向前一个和后一个节点的指针,因此比ArrayList更占内存。
- 使用场景:ArrayList适用于需要频繁进行随机访问的场景;而 LinkedList 在首尾操作、或已由迭代器定位到位置后插删时才有 O(1) 的链接调整优势;按索引插删仍需 O(n) 定位。
参考回答:
- ArrayList:基于动态数组,连续存放元素引用,适合下标访问(随机访问),扩容机制:因为数组长度固定,超出长度存数据时需要新建数组,然后将老数组的数据拷贝到新数组,如果不是尾部插入数据还会涉及到元素的移动(往后复制一份,插入新元素),预估容量可减少扩容复制;尾部追加通常具有较好的局部性,但性能结论应结合实际负载测量
- LinkedList:基于双向链表,首尾操作为 O(1);按索引访问会从较近的一端遍历,最坏 O(n),不能笼统地说所有插删都更快
- 遍历 LinkedList 可用增强 for 或 Iterator,整体 O(n);应避免
for (int i = 0; i < list.size(); i++) list.get(i)这种反复按索引访问的写法,其完整遍历为 O(n²)。indexOf返回未找到时的 -1,也需线性查找。
5、HashMap和HashTable有什么区别?
回答提示:
- 线程安全性:HashMap是非线程安全的,而HashTable是线程安全的。HashTable通过synchronized关键字实现同步,但可能导致性能下降。
- null值处理:HashMap允许null作为键和值,而HashTable不允许。
- 性能:由于HashMap不需要考虑线程同步,通常性能更高。
参考回答:
区别 :
线程安全性
- HashMap方法没有synchronized修饰,线程非安全,HashTable线程安全;
空键和空值:
- HashMap允许key和value为null,而HashTable不允许
历史遗留:(了解)
- Hashtable 是 Java 1.0 中的遗留类,虽然仍然可以使用,但通常建议使用 HashMap,并结合
java.util.concurrent包中的现代并发类来处理多线程问题。 - HashMap 是在 Java 2 中引入的,设计更现代化,使用也更加灵活。
迭代器:(了解)
- HashMap 使用的是快速失败(fail-fast)的迭代器,如果在创建迭代器后对集合进行了结构上的修改(除了使用迭代器自身的
remove方法外),迭代器通常会抛出ConcurrentModificationException,但这是尽力检测,不能据此保证并发安全。 - Hashtable 的
keys()、elements()返回非 fail-fast 的 Enumeration;keySet()、entrySet()等集合视图返回的 Iterator 则是尽力检测的 fail-fast 迭代器。
性能:(了解)
- 在没有线程安全需求的场景中,HashMap 通常比 Hashtable 性能更高,因为它没有同步的开销。
HashMap底层原理
HashMap底层原理 (了解)
- 无参 HashMap 默认负载因子为 0.75,桶数组延迟到首次插入时分配,默认长度 16。通常在新增映射后
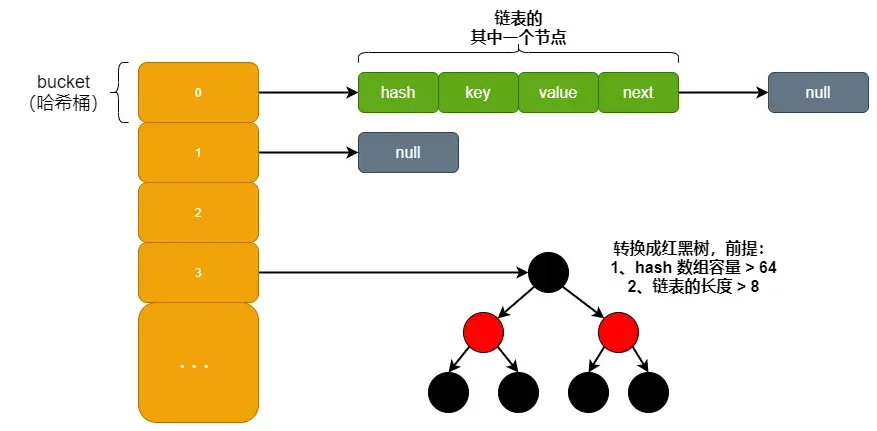
size > threshold才扩容,阈值通常为capacity × loadFactor;默认容量 16 时,第 13 个不同的键触发负载阈值扩容。这里统计的是映射数,不是已占用桶数。扩容通常将数组长度翻倍,并重新分配桶位置,不是按 hashCode 排序;CPU 能执行乘法,采用位运算不是因为“不支持乘法”。 - JDK 7 使用数组加链表;自 JDK 8 起增加红黑树桶。以 OpenJDK 17u 的普通
put路径为例:向已有 8 个节点的链表追加第 9 个不同键时尝试树化;数组长度至少 64 才树化,否则优先扩容。其他插入路径应结合具体源码判断,不能把阈值常量 8 简化成“第 8 个节点必树化”。
底层数据结构
- HashMap 的数组槽位称为桶,保存桶首节点的引用;每个节点才是一个 key-value 映射。在 Java7 中叫 Entry,Java8 中叫 Node。 因为它本身所有的位置都为 null,在 put 插入的时候会根据 key 的 hash 去计算一个 index 值。比如,我 put ("枫斗者",666),在 HashMap 中插入 "枫斗者" 这个元素,通过 hash 算法算出 index 位置是 3。这时的结构如下所示,还是个数组。
| 枫斗者 | |||||||
|---|---|---|---|---|---|---|---|
| 666 | |||||||
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
- 初次 put没 hash 冲突时,若发生 hash 冲突就得引入链表啦。假设我再次 put ("枫哥",666),在 HashMap 中插入 "枫哥" 这个元素,通过 hash 算法算出 index 位置也是 3。这时的结构如下所示:形成了链表
桶数组 table[3] -> Node("枫斗者", 666) -> Node("枫哥", 666) -> null这里只是假设两个键定位到同一桶,并非这些字符串在真实默认容量下的计算结果。
- 再次 put,发生 hash 冲突,它的源码如下所示:「可以看出每个普通节点包含了四个字段:hash、key、value、next,其中 next 表示链表的下一个节点」。
static class Node<K, V> implements Map.Entry<K, V> {
    final int hash;
    final K key;
    V value;
    Node<K, V> next;

    // 省略构造器与接口方法;这是结构摘录
}
JDK 1.8 之后底层是基于数组+链表+红黑树。
底层原理:
先计算扰动哈希:null 键对应 0,否则
h = key.hashCode(); hash = h ^ (h >>> 16);随后以(n - 1) & hash定位桶。数组长度 n 为 2 的幂,这样可用掩码取低位;扰动使高位也参与桶定位,但不能消除碰撞。空桶直接存入节点;非空桶先比较保存的 hash,再判断键是否同一引用或
equals相等。相同键更新 value,不增加 size;不同键进入链表或树桶查找、插入。链表普通 put 的树化条件见上文;树桶按树结构插入。键在存入后不应改变影响 hashCode/equals 的字段,否则可能无法按原键找到映射。
删除时,树桶会按树形结构判断是否退化为链表,并非统一在“剩余 6 个节点”时触发;
UNTREEIFY_THRESHOLD = 6主要用于扩容拆分树桶时,拆分后某侧节点数不超过 6 则转回链表。
扩容为什么无需重新调用每个键的 hashCode()?节点已保存扰动后的 hash,容量从 n 翻倍到 2n 后,只多检查一个二进制位:
旧桶索引 j = hash & (n - 1)
(hash & n) == 0  -> 新索引 j
(hash & n) != 0  -> 新索引 j + n
例如 n=16:hash=3 与 hash=19 原来都在桶3,扩容后分别在桶3、桶19。
OpenJDK 17u 的链表桶拆分保留各自低位组、高位组中的相对顺序;这既不是全表排序,也不赋予 HashMap 迭代顺序保证。实现依据见 HashMap 源码中的 putVal、resize、treeifyBin、removeTreeNode。
如何解决hash冲突?
以下是哈希表的一般策略;OpenJDK 17u 的 HashMap 使用链式桶并在条件满足时树化,不采用下列所有策略。
拉链法,将产生hash碰撞的元素都链接到同一个链表中【形成链表结构】
再哈希法(如双重散列):用另一个哈希函数确定探测步长;仍需合适的表长和步长约束,不能承诺换一个函数就一定消除碰撞。
建立公共溢出区,把哈希表分为基本表和溢出表,将产生哈希冲突的元素存储到公共溢出表
开放寻址法:将产生hash碰撞的元素,去寻找一个新的空闲的哈希地址
线性探测法:就是将在得到的hash值进行加1然后对数组长度取模,直到找到空闲位置。
公式:h(x)=(Hash(x)+i)mod (Hashtable.length);(i会逐渐递增加1)
平方探测法(二次探测):就是将在得到的hash值进行依次为+(i^2)和-(i^2)然后对数组长度取模,直到找到空闲位置。
公式:h_i(x)=(Hash(x) ± i²) mod m;m 为表长。探测序列是否覆盖可用位置取决于表长与探测规则,不能保证任意参数都能找到空位。
HashMap为什么要用到链表结构?(了解)
- 当我们向HashMap中添加元素时,会先根据key进行哈希运算,用扰动后的 hash 与数组长度减一进行按位与得到一个下标,然后通过下标将元素进行存储。如果当前下标位置有数据就产生了哈希碰撞,进行equals比较内容是否相等,如果相等进行覆盖,如果不等,就会在用拉链法然后将这个数据追加到最后一个键值后面,最终形成单向链表。
HashMap为什么选择红黑树?(了解)
- 同一桶中节点较多时,链表查找需要逐个比较。红黑树保持树高 O(log n),对哈希可区分或键可比较的查找有帮助;不能无条件宣称所有恶意碰撞键都保证 O(log n),同 hash 且不可比较的键可能需要搜索两侧子树。
HashMap链表和红黑树在什么情况下转换的?(了解)
- OpenJDK 17u:普通 put 向含 8 节点的链表追加新键时尝试树化,容量不足 64 则扩容;扩容拆分树桶后,某侧节点数不超过 6 时退化为链表;直接删除时则根据树形判断。树化与退化使用不同条件,避免简单增删造成频繁转换。
HashMap在什么情况下扩容?(了解)
- 无参构造默认首次插入分配 16 个桶;此后新增映射使 size 超过阈值时通常翻倍。默认阈值为
16 × 0.75 = 12,更新已有键的值不增加 size,因此不会仅因更新触发该扩容条件。 - 桶链表达到树化尝试条件但数组长度小于 64 时,也会优先扩容;容量达到实现上限时不再翻倍。扩容保留原键对象和值对象,仅调整节点所在桶,迁移机制见上面的位拆分示意。
HashMap是如何Put一个元素的 ?
- 首先,计算 key 的扰动 hash,再用
(n - 1) & hash,计算出索引(下标)。此时判断该索引位置是否已经有元素了,如果没有,就直接放到这个位置。如果这个位置已经有元素了,也就是产生了哈希碰撞,那么判断旧元素的key和新元素的key的hash值是否相同,并且将他们进行equals比较,如果相同证明是同一个key,就覆盖旧 value,并返回旧 value,如果不相同的话再判断当前桶是链表还是红黑树,如果是红黑树,就按红黑树的方式,写入该数据,如果是链表,就依次遍历并比较当前节点的key和新元素的key是否相同,如果相同就覆盖,如果不同就接着往下找,直到找到空节点并把数据封装成新节点挂到链表尾部。然后需要判断,追加前链表是否已有 8 个节点,若满足树化尝试条件则调用 treeifyBin(容量不足 64 时改为扩容),最后判断数组长度是否需要扩容。
HashMap是如何Get一个元素的?(了解)
- 首先将key进行哈希运算,计算出数组中的索引位置,判断该索引位置是否有元素,如果没有,就返回null,如果有值,判断该数据的key是否为查询的key,如果是就返回当前值的value
- 如果第一个元素的key不匹配,判断是红黑树还是链表,如果是红黑树,就就按照红黑树的查询方式查找元素并返回,如果是链表,就遍历并匹配key,然后返回 value;找不到返回 null。由于允许 null 值,必要时用 containsKey 区分缺失键和映射到 null 的键
你知道HahsMap死循环问题吗 ?(了解)
- 历史上的 JDK 7 HashMap 在扩容数组时采用头插迁移,会将旧数据迁徙到新数组中,这个操作会将原来链表中的数据颠倒,比如a->b->null,转换成b->a->null这个过程单线程是没有问题的,但是在多线程环境,可能因并发交错形成环,例如a->b->a->b....,这就是死循环
- 在JDK1.8后,做了改进保留了扩容拆分后每组链表内部的相对顺序,避免了上述 JDK 7 头插迁移导致成环的机制。但还是会出现高并发时数据丢失的问题,因此在多线程情况下还是建议使用ConcurrentHashMap来保证线程安全问题
官方资料(Java SE 17 / OpenJDK 17u)
- Collection API、Queue API:接口层次与队列顺序语义。
- ArrayList 源码、LinkedList API:延迟分配、增长策略与索引遍历。
- Hashtable API:Enumeration 与集合视图 Iterator 的区别。
- ConcurrentHashMap API、CopyOnWriteArrayList API、Collections.synchronizedMap、Stack API:并发语义、快照迭代与替代接口。
- OpenJDK 7u HashMap 源码、OpenJDK 17u ConcurrentHashMap 源码:历史迁移方式与现代并发实现。